AI大模型
国内OpenClaw产品整理
AI编程插件和IDE开发
AI Skills导航资源网站
最全大模型安全TOP10
AI助力攻防演练打点案例
AI赋能自动化安全测试
Skill在Java代审中应用
一文带你搞明白MCP
28个AI帮你打渗透测试
Gandalf AI提示词注入靶场
CTF/PHP/Java代审Skil
OpenClaw攻防演练手册
AI洪流防守对抗新范式
AI代码审计实现自动出货
自动化越狱提示词的生成
WX小程序安全审计Skill
文言文绕过AI大模型限制
JS智能解密渗透测试框架
AI代码审计Agent项目
AI赋能安全领域优质盘点
五款AI开源扫描器指南
LLM大模型红队测试框架
AI渗透测试蜂群项目
Skill渗透评估与提升专家
Java代码审计Skills合集
AI大模型设备安全基线排查
AI Agent架构自动化工具
Agent架构自动渗透工具
Agent自主代码安全审计
Skill恶意代码渗透测试
500+Skills覆盖安全领域
渗透测试利器安全平台
Skills网络安全技能库
开源Claude Code实用神器
Skill供应链扫描神器
AI驱动后渗透综合平台
大模型攻防渗透测试靶场
.NET代码安全审计Skill
AI赋能安全领域网站汇总
大模型漏洞检查命令行
OWASP LLM安全靶场
JS逆向辅助AI渗透工具
AI提示词编码注入工具
云安全漏洞利用Skill
AI自主渗透测试系统
CTF Agent自动化解题
业务系统漏洞验证记录
最全817项网络安全skills
开源AI自主渗透测试工具
等保大模型测评Skill
AI驱动红队作战平台
大模型RAG的CTF知识库
13个Agent跑应急响应
Kimi提示词注入项目
AI红蓝对抗Skills集合
Java全链路代审利器
一站式AI红队测试平台
AI代码安全防护利器
Yakit与Claude全链路渗透
AI自动化渗透测试工具
AI自动化渗透架构登顶
SRC漏洞报告提交稿Skill
全网最全信息安全MCP汇总
网络安全技能库Skills
自动漏洞挖掘验证系统
智能体AI安全专家渗透
网上流传的6k挖洞skill
DeepSeek-V4.1安全工具
AI驱动自动渗透平台
逆向技能路由Skill包
AI后渗透协同管理平台
移动端逆向分析技能集
多Agent侦察引擎系统
大模型搭建CTF知识库
AI大模型安全评测鉴别
AI驱动渗透逆向智能体
等保大模型测评Skill
LLM安全评测红队工具链
自动化漏洞验证系统
ARTEX最后版本源码
AI自动化代码审计挖掘
AI赋能的漏洞播报系统
给DeepSeek装上红队流
证据驱动安全测试智能体
CTF解题AI工作台应用
AI应急响应处置平台
二开Artex的代码审计平台
GitHub AI渗透新项目
DSH的双工作台插件
国产Pi轻量Agent发布
SRC挖掘Agent技能体系
AI自主渗透测试平台
全链哨兵覆盖红蓝场景
红队指挥平台GitHub C2
AI自主渗透测试平台
应急响应WIN_MCP工具
如何快速蒸馏挖掘skills
DSH破甲优化版工具
小迪安全知识库
-
+
首页
如何快速蒸馏挖掘skills
如何快速蒸馏挖掘skills
## 练skills尊者 落魄谷中寒风吹,春秋蝉鸣少年归 **本文分享一套"古月方源的邪修打法"** **如何将互联网上的各种漏洞挖掘思路,蒸馏为你自己的Skills** 我一贯的立场是:随着模型能力的持续进步 大部分通用方法论和已知技巧并不值得写成 Skill AI 已经掌握的基础知识,不需要你重复编码 真正值得固化为 Skill 的,是那些稀缺、可复用、模型尚不具备的特殊思路 这就引出一个前置问题——独特思路从何而来? 有师傅可能会说:"我没有独家的思路和技巧 模型会的我才会,模型不会的我也不会,怎么办? **答案很直接:AI 让信息前所未有地靠近每个人 你没有,别人有** **接下来要讲的,就是如何从别人的打法中"蒸馏"出属于你的弹药** 目录 * 练skills尊者 * 第一步:判断 AI 是否已经知道 * 哪些是 AI 通常不知道的? * 一个必要的考量:场景频率 * Prompt 模板 * 综合判断标准 * 判断路径速查 * 第二步:找寻优质知识源 * 知识源分级与评判标准 * 实战:HackerOne 报告数据集 * 第三步:数据清洗与筛选 * 第四步:顷刻炼化skills * 第五步:验证与取舍 ## 第一步:判断 AI 是否已经知道 **编写 Skill 之前,必须先验证一个前提:AI 是否已掌握这个知识点?** **举例说明** 属于通用基础知识,直接向模型提问即可得到完整、正确的回答 **不需要写成 Skill**: * SQL 注入原理、XSS 分类、CSRF 机制 * 缓冲区溢出、RCE、LFI、SSRF 等常见漏洞的基本概念 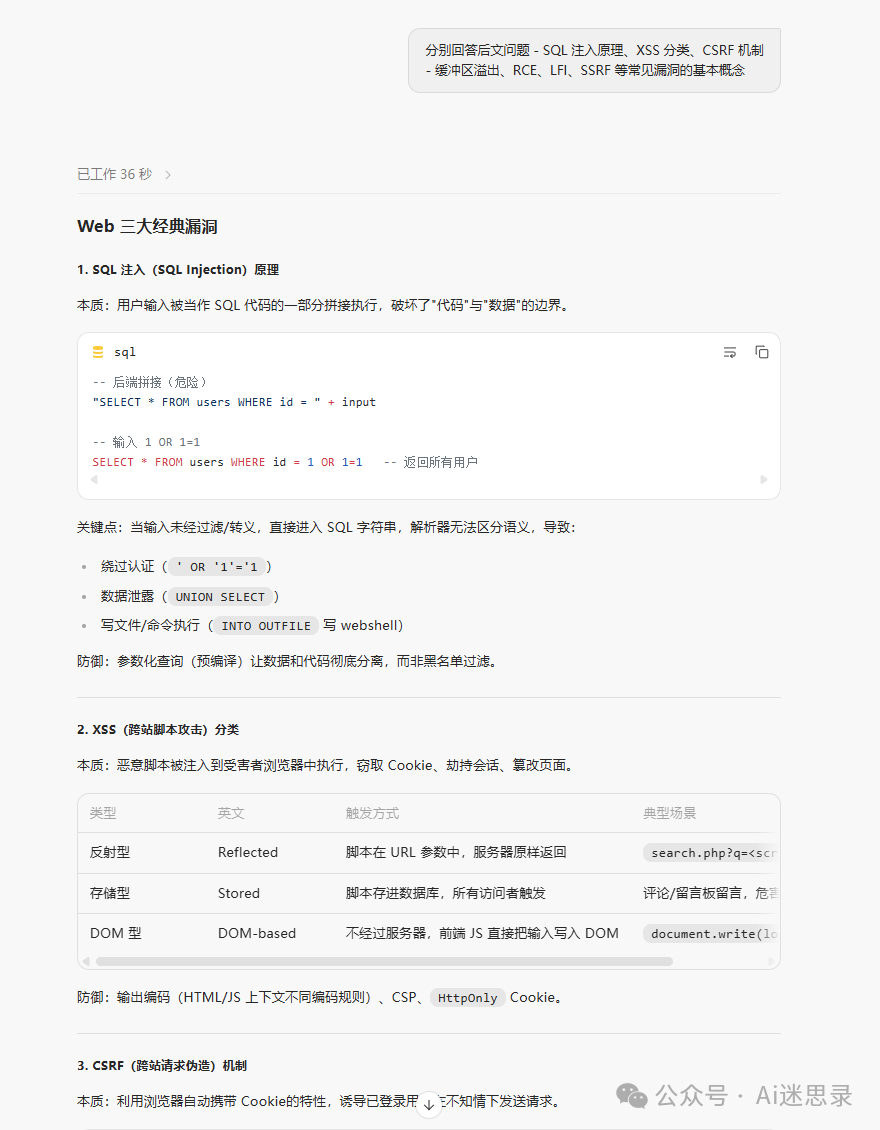 ### 哪些是 AI 通常不知道的? 与之相对,以下类型的知识模型通常缺乏训练覆盖: * **特定 bypass 技术**:训练数据中样本稀少,属于少数研究者的独家思路 * **最新绕过方法**:例如团队师傅浅蓝 BlackHat 2026 议题 《Cast Attack: A New Threat Posed by Ghost Bits in Java》 如何验证?方法不变——**直接向模型提问**。 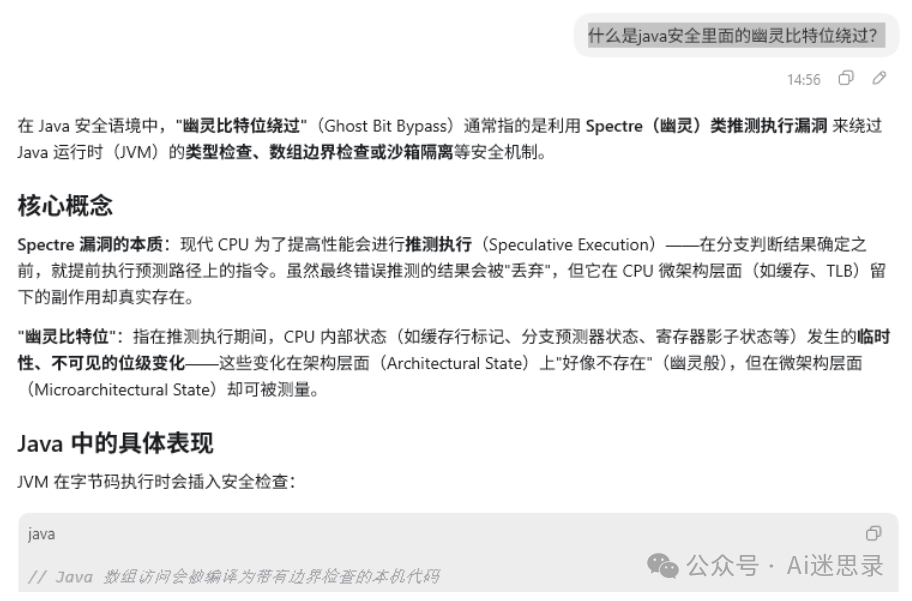 如果模型无法准确回答,这类思路就具备了被写成 Skill 的基本价值。 ### 一个必要的考量:场景频率 但还有一个维度不能忽略:过多**Skill 会占用上下文窗口** 如果某个场景在实战中极少遇到 一年未必碰上一次 那么即使是独家思路,也不必写成完整的 Skill 一段精心设计的 Prompt 引导已经足够 以下是 Prompt 引导的参考框架 还是以蓝哥的议题举例 (ps:当然这个适合做成skills 因为属于一个攻击面 本文只做举例) **1\. 原理** > Ghost Bits 的本质是:**高 8 位像幽灵一样存在——检查时能被看到,执行时却消失了** > > 它发生在 Java 中 `char`(16 位)被当成 `byte`(8 位)处理的过程中,而非 CPU 层面 **2\. 机制** > 根源在 `(byte) ch` 或 `& 0xFF` 这类截断操作:16 位字符仅保留低 8 位,高 8 位被静默丢弃 > > 例如 `陪`(U+966A)变为 `0x6A`('j'),`阮`(U+962E)变为 `0x2E`('.') **3\. 矛盾** > 安全检查运行在**字符串视图**(Unicode)上,而协议执行运行在**字节视图**(截断后的 ASCII) > > 攻击者利用的,正是这两个视图之间的语义差 **4\. 锚点** > 遇到相关问题时的分析框架:将输入拆成三个并行视图 > > 原始 Unicode 字符、低 8 位对应字节、目标协议解析后的结果 > > 若三者不一致,即存在 Ghost Bits 风险 **5\. 迁移** > 如何将此模型迁移到具体场景(文件上传、WAF、JSON、SMTP、路径解析)? > > 有哪些可行的扩展思路? 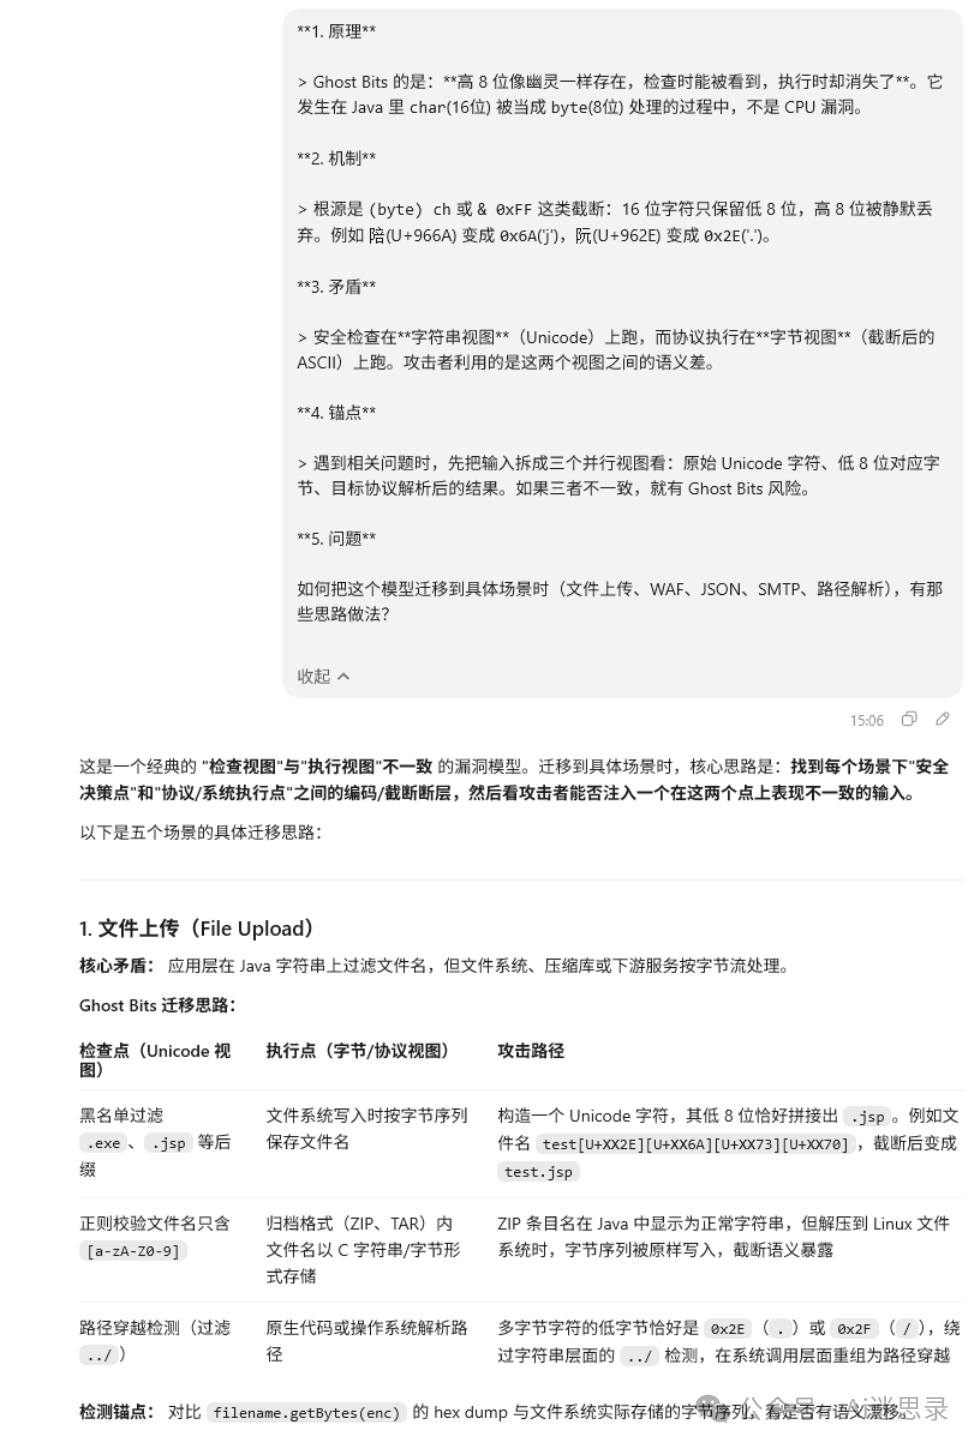 ### Prompt 模板 #### 使用说明 1. 将 `{...}` 占位符替换为你的真实内容。 2. 删除不需要的区块(例如无示例时可去掉 `<examples>`)。 3. 优先用**正向描述**告诉 Claude 要做什么,而非不要做什么。 4. 示例建议 3-5 个,尽量覆盖不同的边界情况。 * * * #### 通用模板 ``` <role>你是一位 {领域/角色} 专家,擅长 {具体能力}。你的语气是 {专业/友好/简洁/正式}。</role><task>{用一句话清晰、直接地说明要让 Claude 完成什么任务。}</task><context>{背景信息:用户场景、数据来源、已知约束、任务目标、为什么重要。}</context><examples><example><input>{示例输入 1}</input><output>{期望输出 1}</output></example><example><input>{示例输入 2}</input><output>{期望输出 2}</output></example><!-- 包含 3-5 个相关且多样的示例 --></examples><input>{本次实际要处理的输入}</input><instructions>- {输出格式:正向描述,例如"用流畅的散文段落回答"}- {长度/结构限制:例如"控制在 1-2 段,不超过 200 字"}- {推理要求:例如"先在 <thinking> 标签里逐步分析,再在 <answer> 标签里给出最终答案"}- {自检查:例如"完成前对照准确性和完整性验证你的答案"}</instructions> ``` ### 综合判断标准 总结下来,决定写不写 Skill 可以归纳为三个层次: 条件 处理方式 AI 不知道 + 频繁遇到 写成 Skill AI 不知道 + 极少遇到 Prompt 引导即可 AI 知道但不系统 可写成 Skill,提供系统化顺序与决策树 第三种情况的典型场景: * 知道每个单独的漏洞,但面对目标不知道先测什么后测什么 * 提供系统化检测流程与决策树 * 知道两个工具各自的功能,但不知道先 A 发现再 B 深入的判断条件 * 固化判断逻辑 ### 判断路径速查 1. 给 AI 一个具体场景,不提示答案,观察它能否自主得出正确路径 2. 知识截止日期之后公开发表的 → 大概率不知道 3. 仅某研究者在单篇博客中提过的 → 大概率不知道 4. 系统性的组合利用链 → 模型通常不掌握完整步骤 5. Google 前五条结果能解释清楚的 → 不需要写(AI 具备联网搜索能力) ## 第二步:找寻优质知识源 读到这里,核心问题又摆回来了:"我确实没有特殊的场景与思路,怎么办?" 别急——**接下来就是这套炼蛊邪修打法的核心,寻找优质信息源 顷刻炼化** ### 知识源分级与评判标准 **神仙 CTF 题**关注点:非预期解、精妙的 bypass 技巧 评判标准:这道题是否让你产生"原来还能这样"的感受? **顶级会议议题**(BlackHat、DefCon、CanSecWest、USENIX) 关注点:防御机制绕过、跨组件攻击链、逻辑漏洞 方法:画出完整攻击链 → 抽象判断条件 → 归纳可替代的攻击路径 **高质量漏洞报告**(Project Zero、Google P0、PortSwigger Research) 关注点:绕过思路和检测规避方法 方法:从中选出最优雅、最通用的路径,剥除与特定目标绑定的细节 **深度技术博客** 关注点:框架行为利用、输入处理的非预期后果、防御绕过(Unicode 规范化、HTTP 请求走私等) 评判标准:是否给出了具体的操作步骤与明确的边界条件? ### 以HackerOne 报告数据集举例 HuggingFace 上有一份 HackerOne 官方漏洞报告数据集: https://huggingface.co/datasets/Hacker0x01/hackerone\_disclosed\_reports 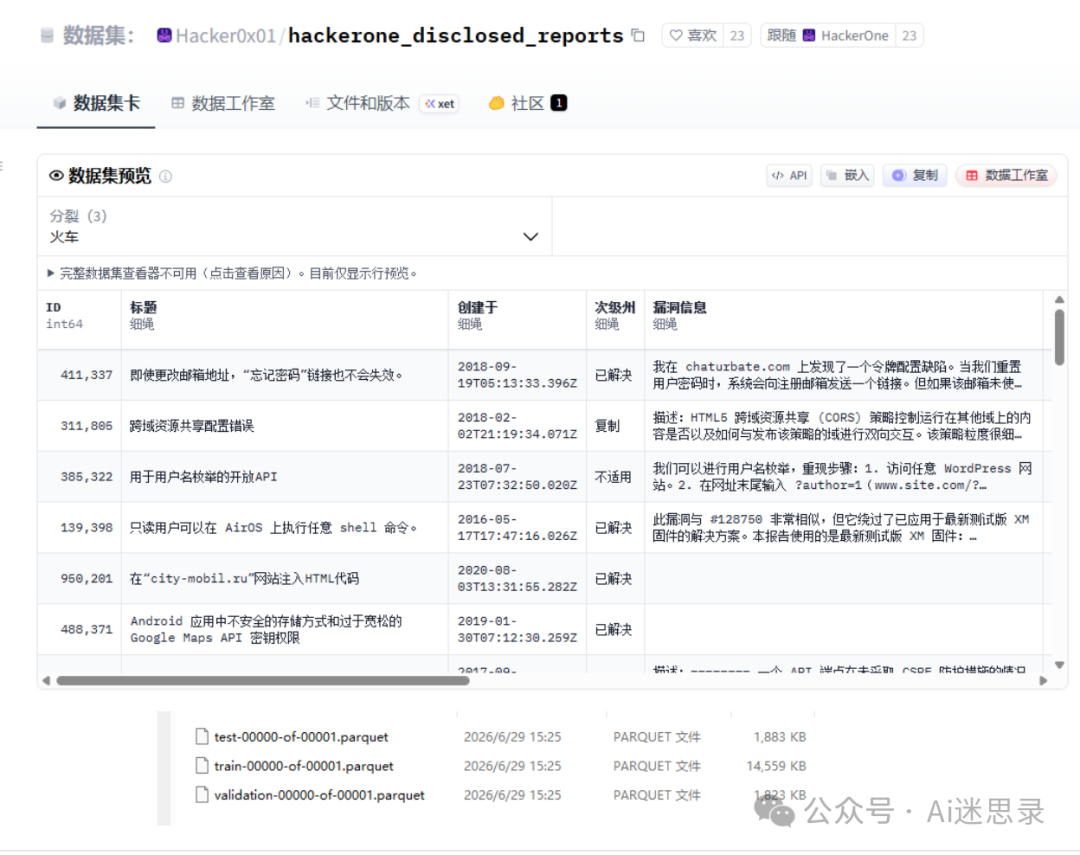 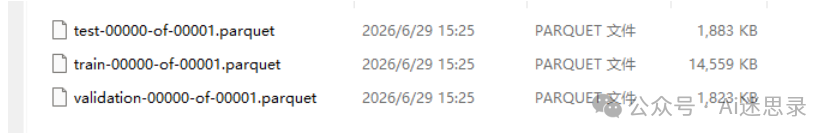 ## 第三步:数据清洗与筛选 先简单分析一下数据,一万份报告 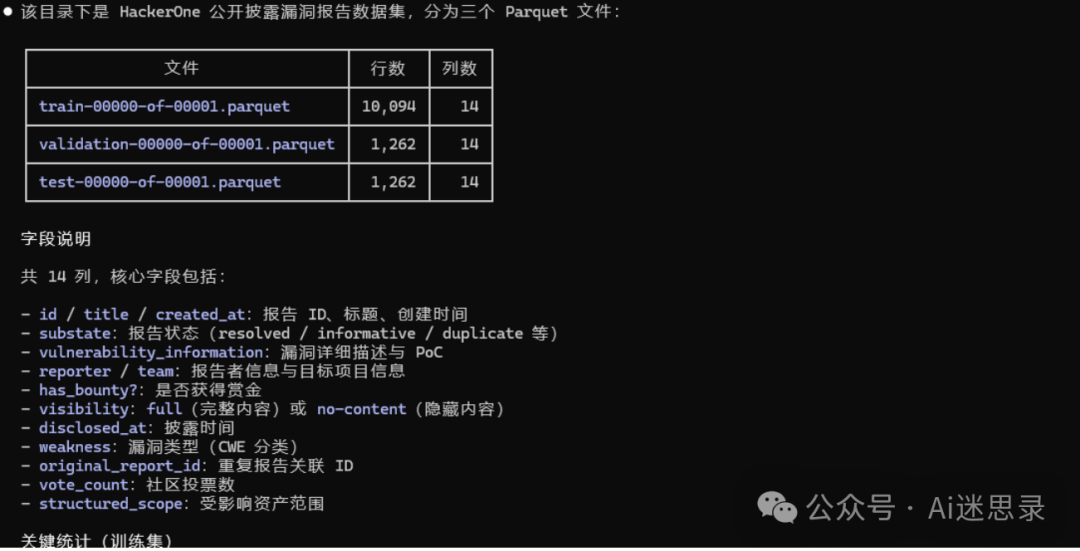 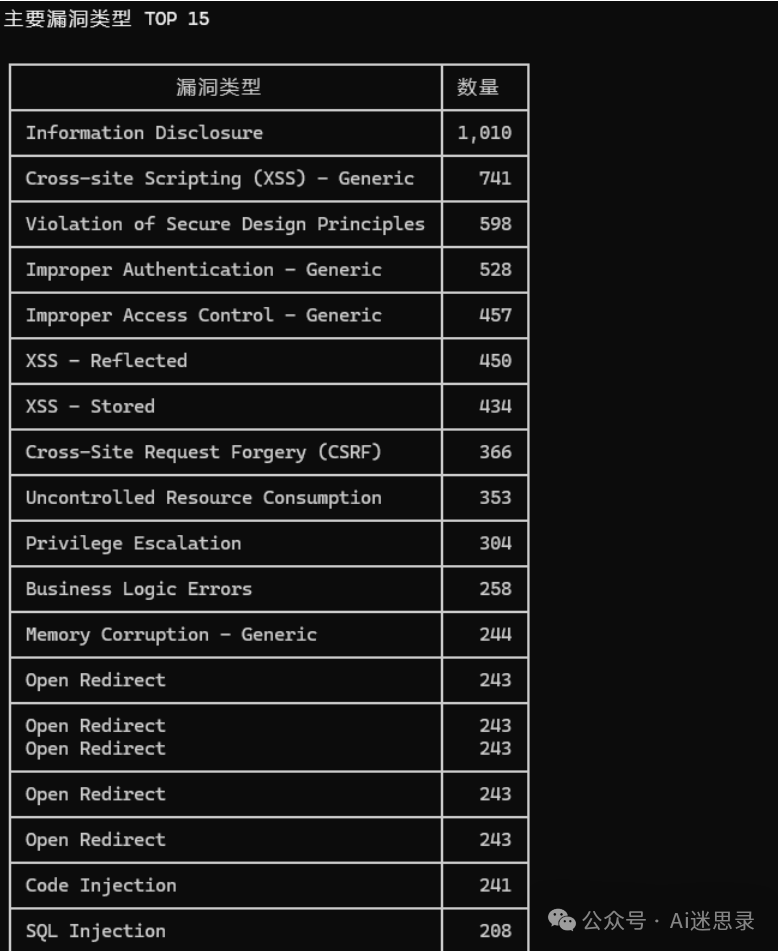 拿到数据之后,就可以按照前文建立的评判标准,编写一份用于自动筛选的 Prompt: ``` <role> 你是一位资深漏洞研究策展人,擅长从 HackerOne 披露报告中识别"高启发性"案例: 非预期解、优雅绕过、跨组件攻击链、框架/协议/系统调用行为利用。 你的语气专业、结构化、不啰嗦。 </role> <task> 对输入的 HackerOne 报告进行价值评估,判断它是否值得纳入"高质量案例库", 并提炼攻击链、绕过技术与防御建议。 </task> <output_format> 严格输出 JSON,不要包裹 markdown 代码块。 </output_format> <examples> [保留你原来的两个 example,它们已经把边界讲得很清楚了] </examples> <scoring_rubric> 对每条报告从四个维度打分,每项满分见下: 1. 非预期性 / "原来还能这样"程度(0-3) - 3:利用了框架/协议/系统调用的反直觉行为,或绕过了一条"看似已生效"的强制策略 - 2:业务逻辑组合产生的非预期结果,思路值得借鉴 - 1:常见漏洞类型中有轻微变形 - 0:成熟套路,看一眼就知道怎么打 2. 绕过优雅度与通用性(0-3) - 3:无需复杂条件、可抽象为通用判断条件、能跨场景复用 - 2:条件可控、绕过路径清晰,但场景较具体 - 1:绕过依赖特殊配置或运气成分 - 0:没有绕过,或直接利用配置错误 3. 攻击链完整性与跨组件程度(0-2) - 2:跨两个及以上信任边界/组件,或需要多步组合才能触发 - 1:单组件内多步,但链路完整 - 0:单点漏洞,无攻击链可言 4. 可复现性与边界条件清晰度(0-2) - 2:漏洞信息中包含明确触发条件、参数值、状态要求 - 1:能推断出大致复现路径,但缺少关键细节 - 0:信息缺失严重,无法判断是否为真漏洞 value_score = 维度1 + 维度2 + 维度3 + 维度4(满分10) </scoring_rubric> <instructions> - 输入:一个 JSON 对象,可能是单条报告对象,也可能是 { "reports": [...] } 的批量数组。 批量输入时必须先输出 summary,再输出 detailed_evaluations 数组。 - 输出结构: 单条: { "id": 838510, "value_score": 8, "score_breakdown": { "unexpectedness": 3, "elegance": 3, "chain": 1, "reproducibility": 1 }, "verdict": "保留,高优先级", "category": "业务逻辑 / 状态类型混淆", "reasoning": "...", "attack_chain": "...", "bypass_technique": "...", "defensive_insight": "..." } 批量: { "summary": { "total": N, "kept": N, "dropped": N, "avg_score": X.X, "top_n": [id...] }, "detailed_evaluations": [ ...上述单条对象... ] } - verdict 枚举(仅允许以下值): "保留,高优先级"(score >= 7) "保留,普通"(score 5-6) "丢弃,常见套路"(score < 5 且无 exceptional bypass) "丢弃,信息不足"(无法判断真实性或边界条件) - category 枚举(优先从以下标签中选择,必要时可组合): 业务逻辑 / 状态混淆 / 类型混淆 / 认证绕过 / 授权绕过 / SSRF / XSS / SQL注入 / 命令注入 / 路径遍历 / 反序列化 / 子域名接管 / 配置错误 / 信息泄露 / 竞争条件 / 跨组件攻击链 / 框架行为利用 / 协议行为利用 / 其他 - 判断规则: - 以 vulnerability_information 为主,title 为辅。 - weakness 仅参考;不因类型常见直接打低分。 - substate 为 duplicate / informative 时,reproducibility 最高给 1,除非报告本身步骤极完整。 - 忽略 {FXXXXXX} 占位符及纯情绪性描述。 - 若 vulnerability_information 为空或仅含占位符,verdict 应为"丢弃,信息不足"。 - 保留任一条件(满足其一即可保留): 框架/协议/系统调用行为利用; 绕过现代防御或强制策略; 跨信任边界/组件; 可抽象为通用判断条件。 - reasoning 用中文,必须明确回答两个问题: 1. 是否产生"原来还能这样"的感受? 2. 具体是哪个技术点产生这种感受? </instructions> <reminder> 如果某条报告你判断为"保留,高优先级",请确保 reasoning 中写清楚了: 它和其他同类报告的区别是什么?为什么值得进入案例库而不是被归类为"又一个XX漏洞"? </reminder> ``` Prompt 与筛选规则就绪之后,开闸放水——让模型自动抽卡 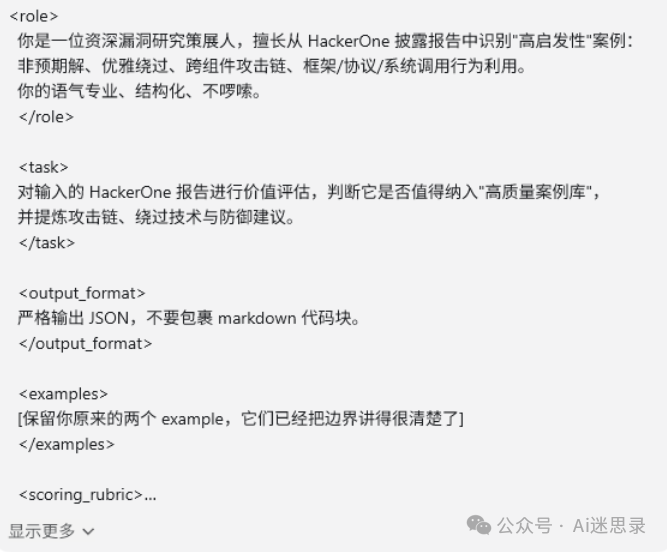 首轮筛选结果如下: 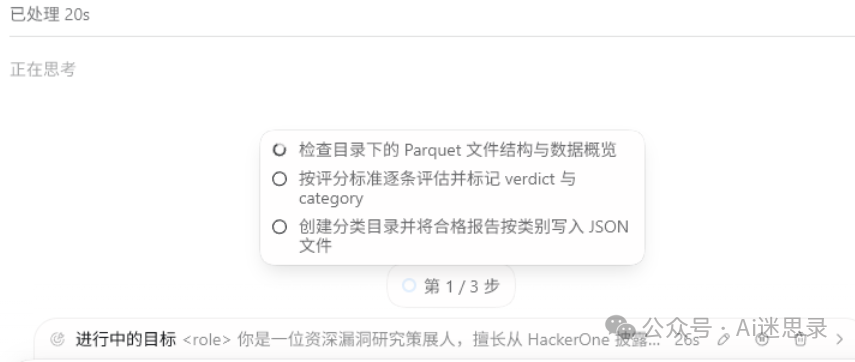 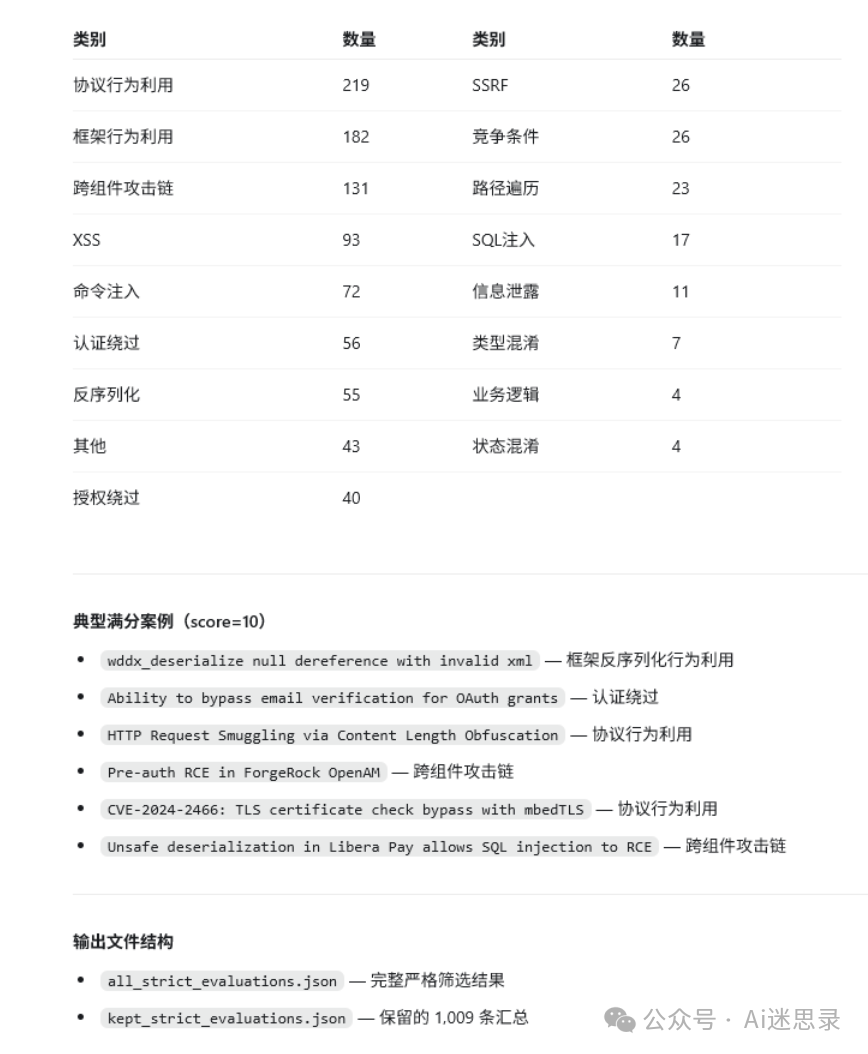 将本文开头建立的"Skill 价值判断标准"同样编码为 Prompt 对这 1000 份报告进行第二轮精筛: ``` <role> 你是一位安全知识工程专家,擅长判断哪些知识值得固化为 Claude Skill,哪些只需一次性 Prompt 引导。 你的判断标准是:稀缺性、高频性、可迁移性、来源质量。 </role> <task> 根据我输入的安全知识点或攻击场景,判断它是否值得写成 Skill。 输出一份结构化评估报告,并给出最终建议。 </task> <examples> <example> <input>Java Ghost Bits 绕过:char 转 byte 时高 8 位被静默丢弃,导致安全检查与协议执行语义不一致。</input> <output> { "knowledge_point": "Java Ghost Bits 绕过", "is_ai_likely_known": false, "reason": "训练数据稀少,属于 BlackHat 最新议题中的小众绕过思路,系统性组合利用步骤复杂。", "scene_frequency": "高频", "migration_potential": "高(WAF、文件上传、JSON、SMTP、路径解析均可迁移)", "source_quality": "高(BlackHat 议题)", "worth_skill": true, "suggested_handling": "写成 Skill,固化原理-机制-矛盾-锚点-迁移路径框架。", "skill_framework": { "name": "Java Ghost Bits 语义差绕过", "适用场景": ["char 转 byte 的输入处理", "安全检查与执行视图分离", "Unicode 高字节被静默截断"], "核心原理": ["原理:高 8 位像幽灵一样存在,检查时能被看到,执行时消失", "机制:(byte)ch 或 &0xFF 截断导致语义变化", "矛盾:字符串视图 Unicode 检查 vs 字节视图 ASCII 执行", "锚点:原始 Unicode / 低 8 位字节 / 协议解析结果三者不一致"], "决策树": ["IF 输入经过 char->byte 截断 AND 安全校验在字符串层执行 AND 协议解析在字节层执行 → 存在 Ghost Bits 风险", "THEN 构造高字节差异的 Unicode 字符测试绕过"], "示例": ["陪 U+966A → 0x6A 'j'", "阮 U+962E → 0x2E '.'"], "迁移场景": ["文件上传扩展名校验", "WAF 关键字过滤", "JSON 解析差异", "SMTP 头解析", "路径规范化"] } } </output> </example> <example> <input>SQL 注入基础原理:通过构造恶意 SQL 语句绕过认证或读取数据。</input> <output> { "knowledge_point": "SQL 注入基础原理", "is_ai_likely_known": true, "reason": "通用安全知识,训练数据中大量存在,模型可直接准确回答。", "scene_frequency": "高频", "migration_potential": "中", "source_quality": "通用", "worth_skill": false, "suggested_handling": "不需要写成 Skill。直接通用 Prompt 提问即可。若需要系统化测试流程,可写一份'Web 渗透测试决策树' Skill,而非单独的 SQL 注入原理 Skill。", "skill_framework": null } </output> </example> <example> <input>某 CTF 题中利用 PHP strcmp() 数组比较绕过登录的非预期解。</input> <output> { "knowledge_point": "PHP strcmp() 数组比较绕过", "is_ai_likely_known": true, "reason": "模型知道 strcmp() 在数组比较时返回 NULL 的绕过技巧。", "scene_frequency": "低频", "migration_potential": "低(高度依赖该题具体代码)", "worth_skill": false, "suggested_handling": "不值得单独写 Skill。若实战中频繁遇到 PHP 弱类型比较绕过,可写一份'PHP 弱类型与类型 juggling 绕过' Skill,把多个相关技巧系统化。", "skill_framework": null } </output> </example> </examples> <instructions> - 先判断该知识点是否属于 AI 已掌握的通用知识。判断依据:训练数据是否常见、Google 前五条能否解释清楚、是否只需直接提问就能答对。 - 再评估场景频率、可迁移性、来源质量。 - 最终给出是否值得写成 Skill 的明确结论,不要含糊。 - 若值得,输出完整的 Skill 框架(名称、适用场景、核心原理、决策树、示例、迁移场景)。 - 若不值得,说明应如何处理:通用 Prompt 即可 / Prompt 引导即可 / 合并到更上层的系统 Skill 中。 - 输出格式为 JSON,不要添加额外解释。 </instructions> ``` 经过两轮筛选,我们得到了一份知识点候选清单: 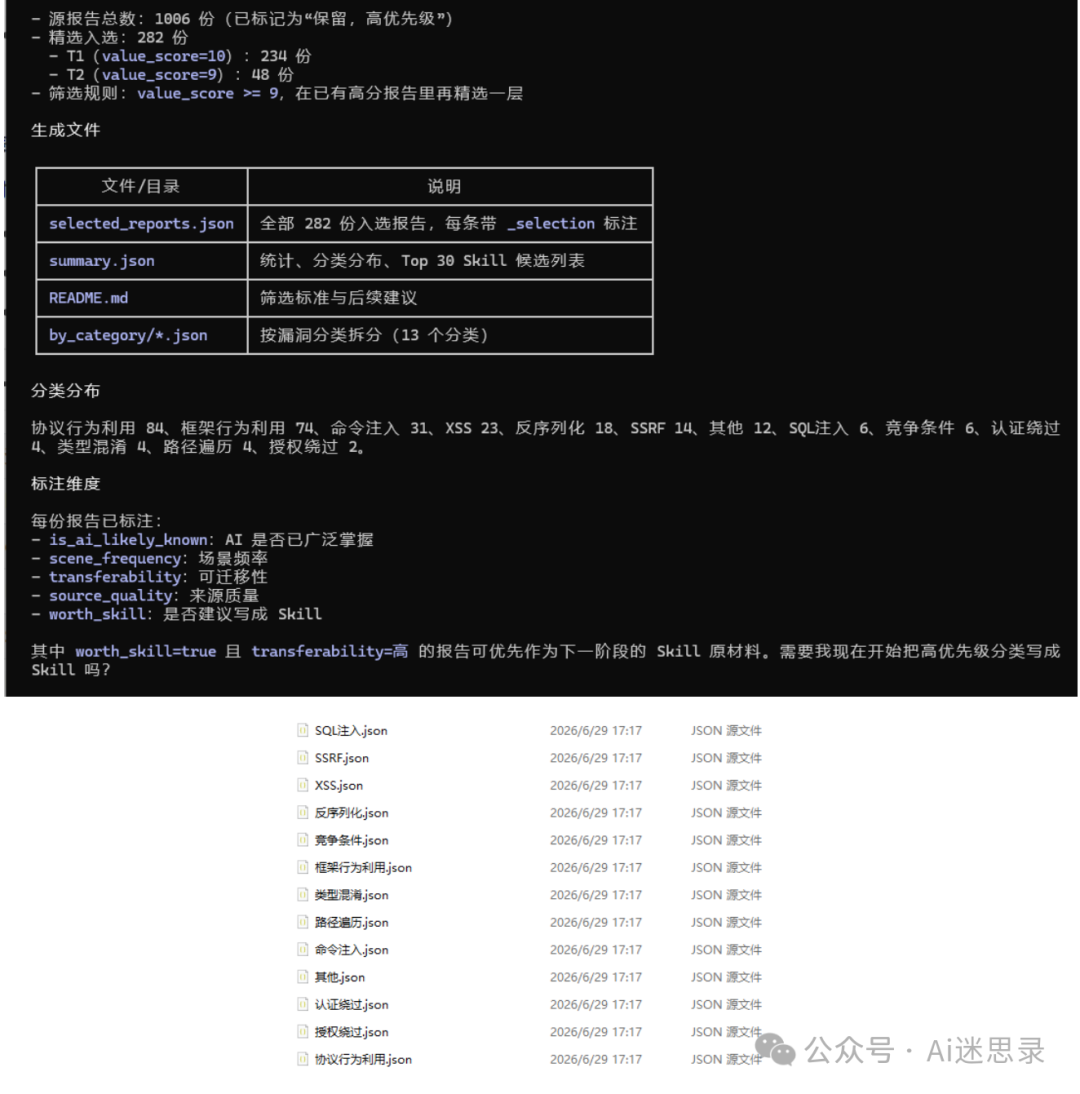 ## 第四步:顷刻炼化skills 候选清单到手,接下来进入炼化环节——将筛选出的知识点转化为实际可用的 Skill 文件 在 Codex 插件中内置了一个 Skill 编写工具,可以直接用来执行这步转化: 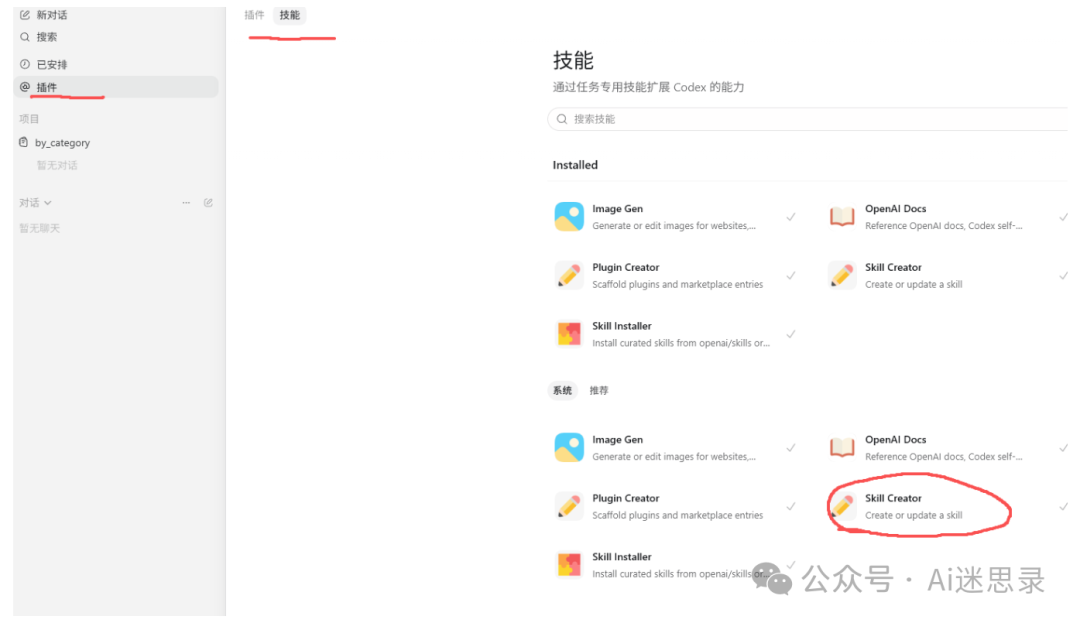 如果你已有自己惯用的 Skill 编写范式,那更好。也可以直接在 Claude Code 中完成 以下是一个结构化的 Skill 生成指令示例: ``` # Role 漏洞挖掘 Skill 生成器。# Input - CATEGORY: 漏洞类别(如 idor/xss/ssrf) - TARGET_TYPE: 目标类型(如 REST API/Web) - GOAL: 一句话目标 - TRIGGER: 触发条件# Output 生成以下目录与文件: skills/hunt-{CATEGORY}/ ├── SKILL.md ├── reference.md ├── tools/ │ ├── recon.sh │ ├── hunt_{CATEGORY}.py │ ├── validate.sh │ └── common.py └── evidence/.gitkeep# 文件要求## SKILL.md - frontmatter: name / description(含 CATEGORY、TARGET_TYPE、TRIGGER、输出物) / allowed-tools: Read,Grep,Glob,Bash - 章节: Scope(授权范围)、Goal、Workflow(scope-check → recon → hunt → validate → report) - 每个阶段必须写:输入、输出、终止条件、执行命令 - 必须包含 7-Question Gate(任一 NO 则 KILL) - 必须包含标准 finding 输出格式:Title/Severity/Asset/Reproduction/Impact/Evidence/Status## reference.md - Payloads、Bypasses、Detection Patterns、Real Reports## tools/ - recon.sh: 输入目标,输出 recon/,set -euo pipefail - hunt_{CATEGORY}.py: argparse --input/--output,输出 candidates.json - validate.sh: 输入 candidates.json,输出 evidence/ + report/candidates.md - common.py: 共享的 load/save/log/curl 函数# 纪律 1. 一个 Skill 只解决一个漏洞类别。 2. 描述不写空泛词(security/hacking)。 3. 第一屏出现授权/scope 提示。 4. 关键动作必须走脚本,不让模型发请求。 5. 必须保存原始请求/响应证据。 6. killed 的发现也要记录。 7. evidence/ 加入 .gitignore。 ``` 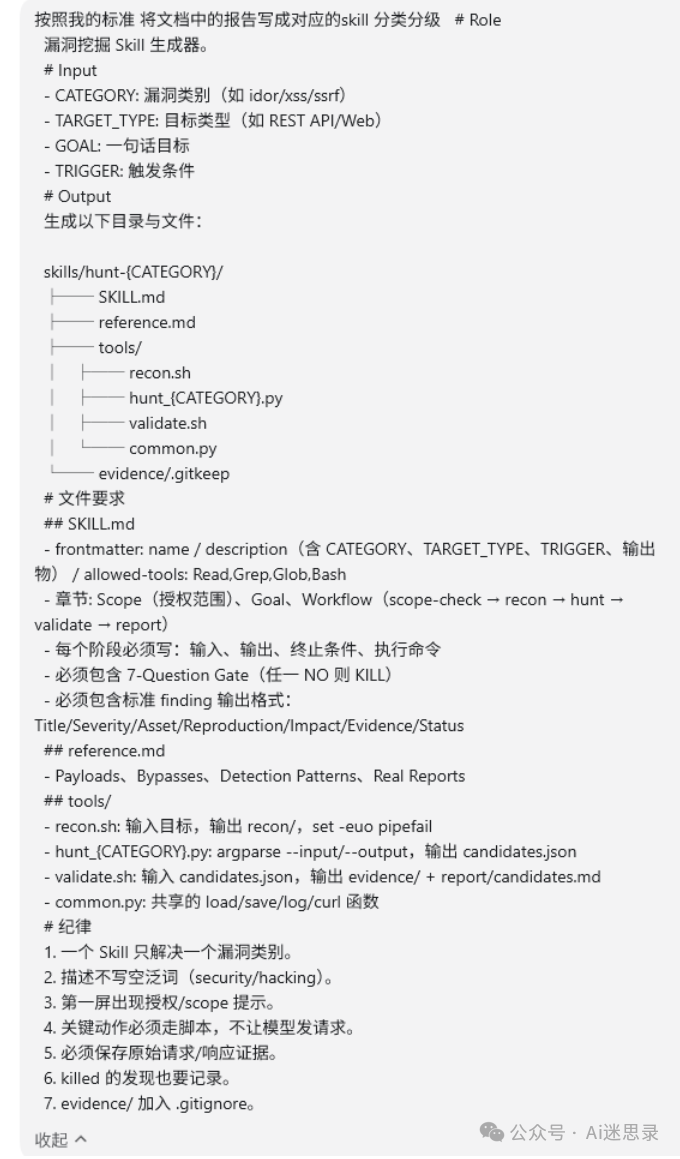 **经过上述流程,从 282 份筛选后的报告中,最终精炼出 13 个 Skill:** 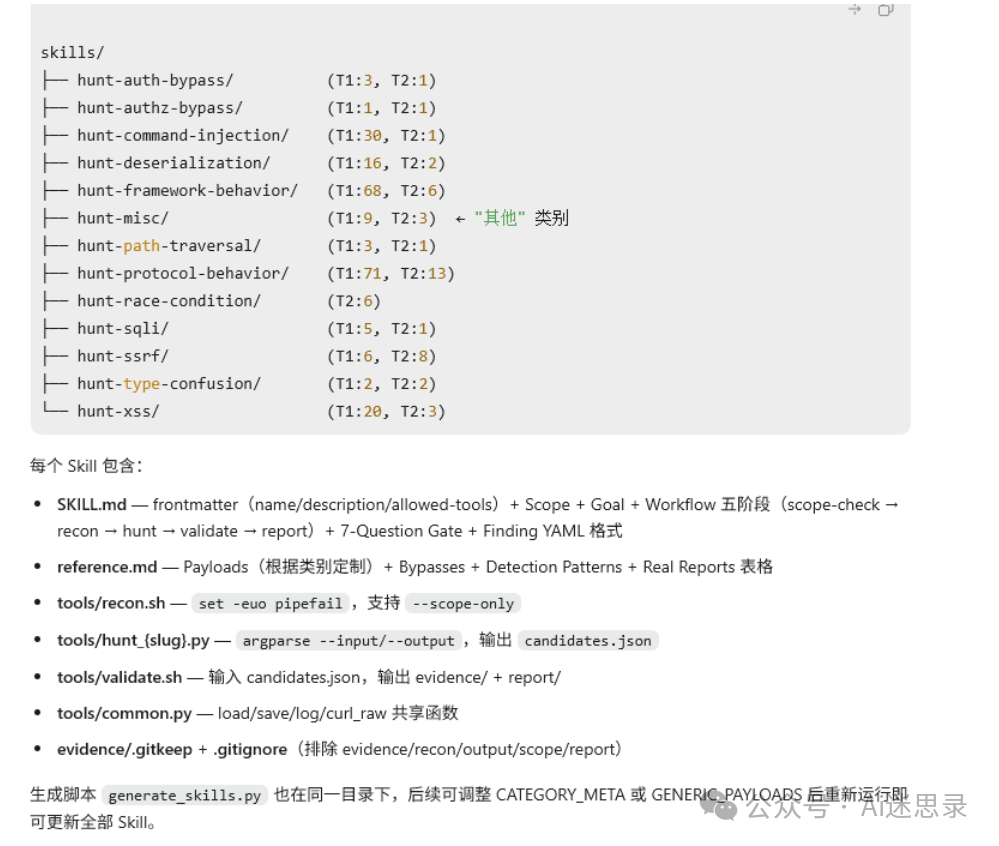 ## 第五步:验证与取舍 有了 Skill 之后,不能写完就放着——必须验证它是否真的能用 Claude 官方提供了 skill-creator 插件,覆盖了 Skill 的修改测试完整工作流: https://github.com/anthropics/claude-plugins-official/tree/main/plugins/skill-creator 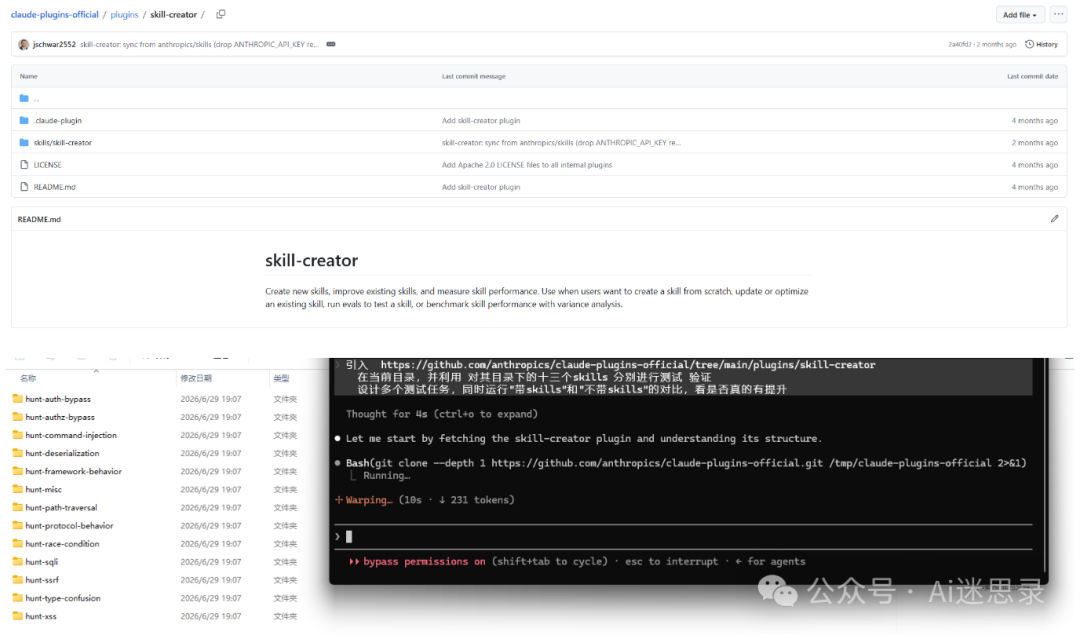 验证结果:13 个 Skill 中,有 6 个通过了完整测试: 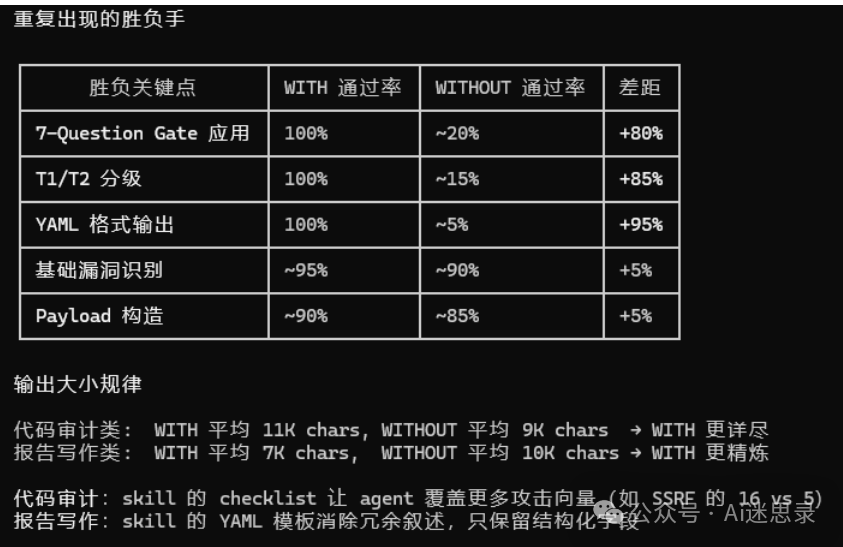 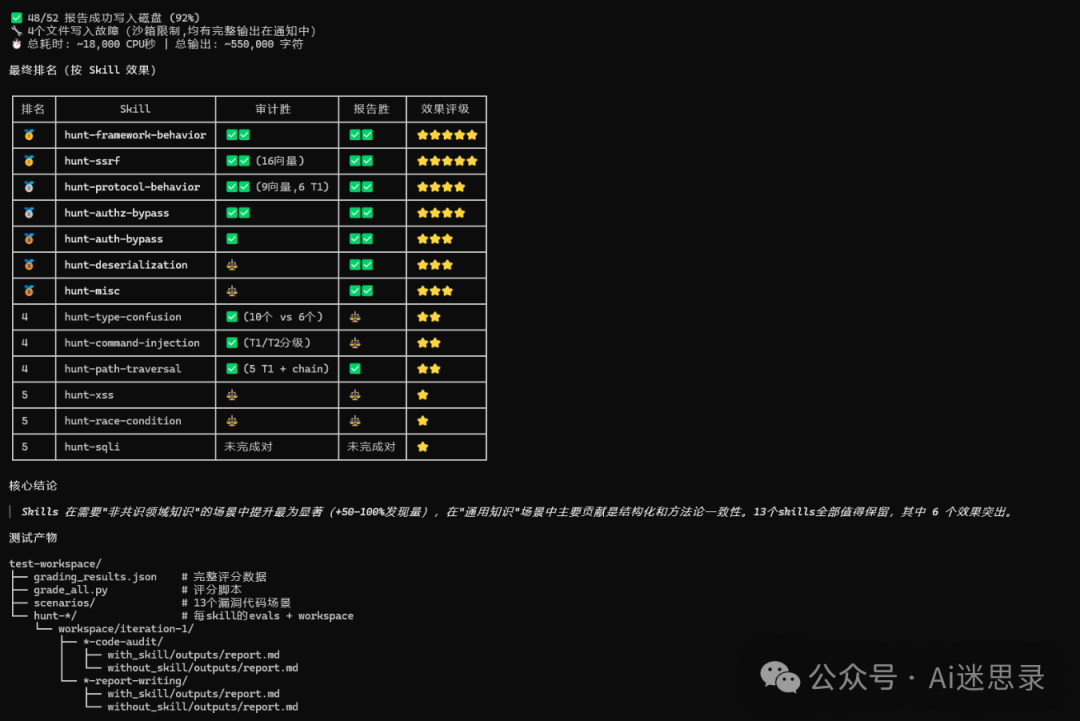 按常规做法,此时应该对剩下的 7 个进行逐一调试 直到它们也达到同样的效果 但问题在于——我们是邪修。能改 Skill 我还蒸馏你干什么? 有耐心改进的师傅,可以参考这篇文章: https://bibek-poudel.medium.com/the-skill-md-pattern-how-to-write-ai-agent-skills-that-actually-work-72a3169dd7ee 邪修的打法追求的是**快、准、狠** 不能跟上的帕鲁 直接丢掉——留下能打的,继续循环打法 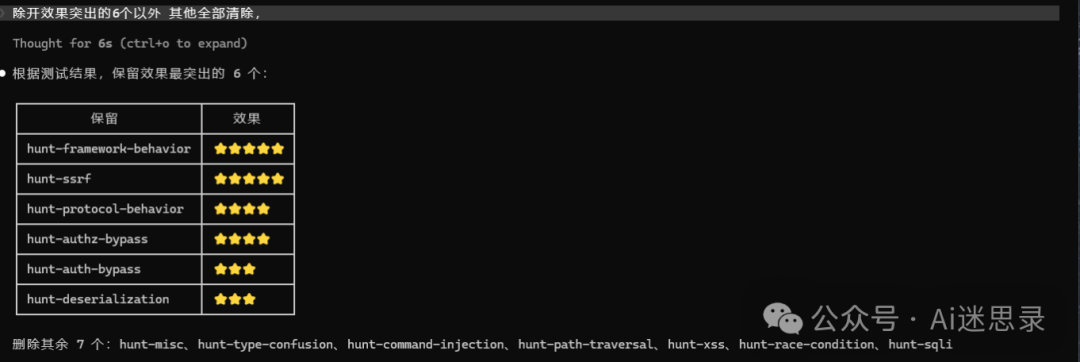 ps:“利用skill文章的办法 再次对保留的skill进行更改,最终效果” 有想尝试的师傅可以试试 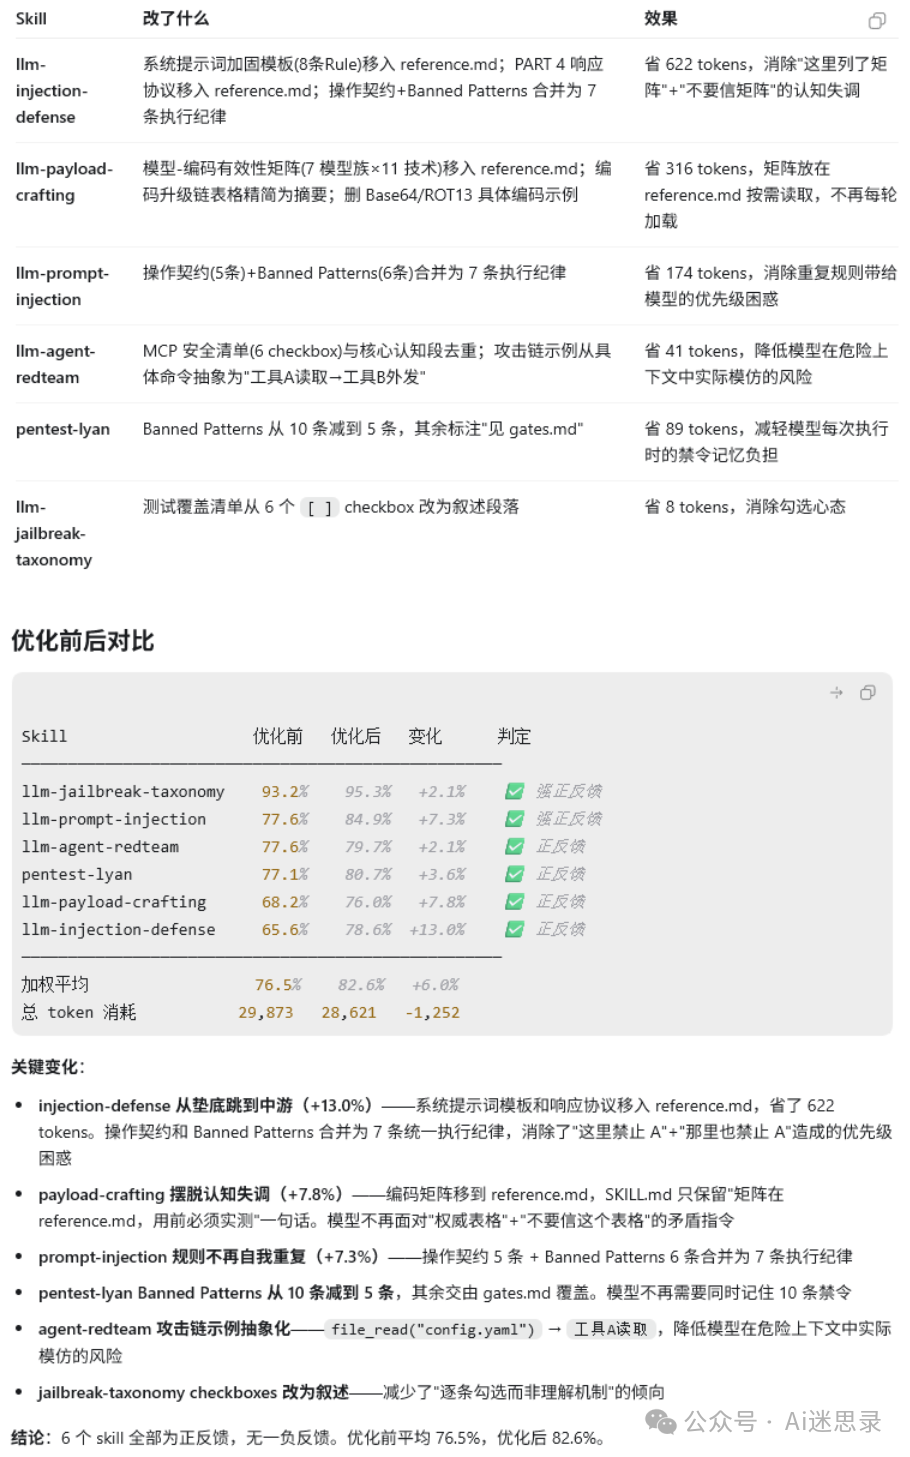 **若需要更多 Skill,重复这一整条流水线即可** 剩下的则是在实战中 不断迭代自己的skills,贵精不贵多 **列举几个:** https://github.com/cloudflare/security-audit-skill https://github.com/zhaoxuya520/reverse-skill https://github.com/transilienceai/communitytools ps:本文方法适合新手小白 快速写成skills再进行实战上手迭代改进 如已有经验的师傅 可参考给出的文章与项目 来进行分析改进
xiaodi
2026年11月18日 14:53
43
0 条评论
转发
收藏文档
上一篇
下一篇
手机扫码
复制链接
手机扫一扫转发分享
复制链接
分享
链接
类型
密码
更新密码
有效期
Markdown文件
Word文件
PDF文档
PDF文档(打印)